RAG: las tres funciones detrás del misterio
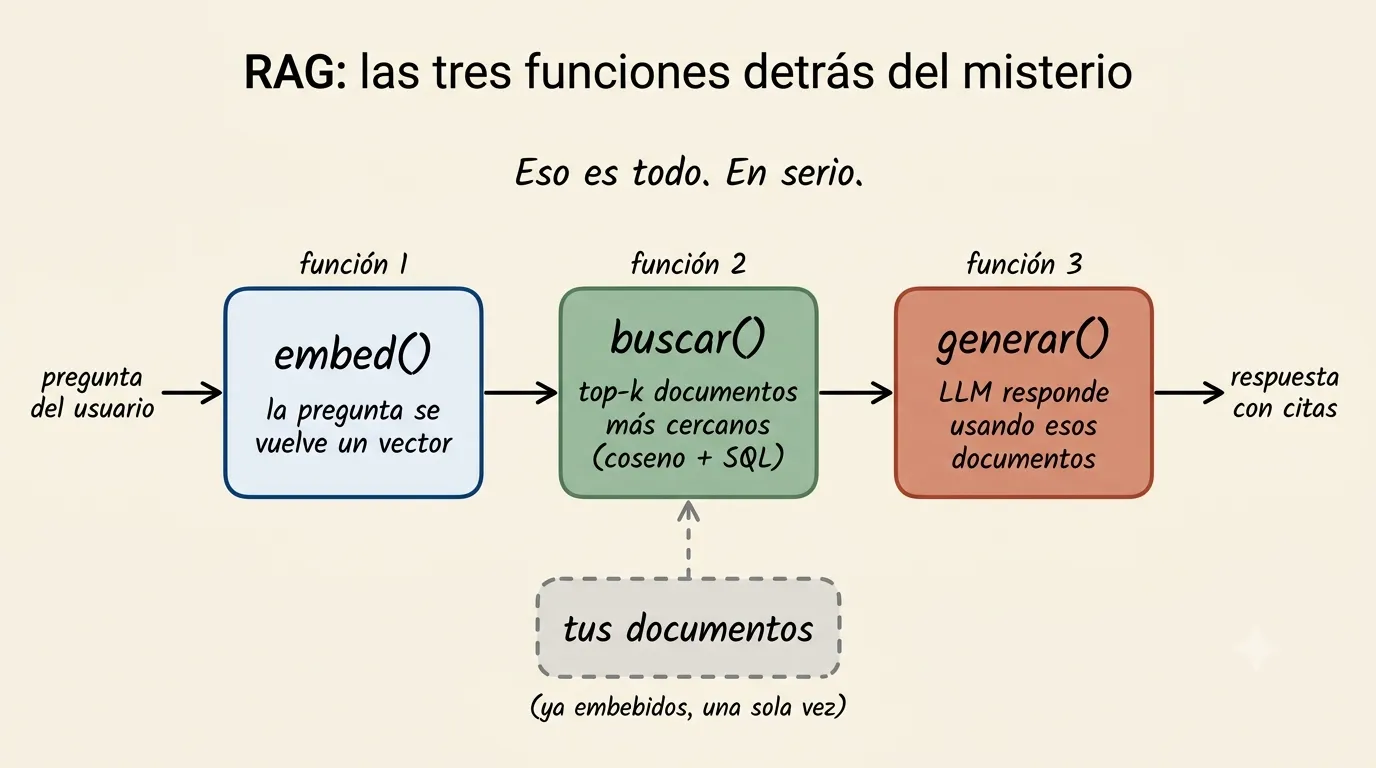
El sistema por el que las empresas están pagando fortunas, “un chatbot que responde sobre NUESTROS documentos”, son tres funciones de Python.
Se llama RAG (Retrieval-Augmented Generation) y el aura de misterio que lo rodea es inversamente proporcional a lo que tiene adentro:
-
embed(pregunta) → la pregunta del usuario se convierte en un vector, un punto en un espacio de significados.
-
buscar(vector) → se recuperan los k documentos más cercanos a ese punto. Con los documentos en Postgres, esto es literalmente una query SQL con ORDER BY de similitud coseno.
-
generar(pregunta, documentos) → un LLM responde usando esos documentos como contexto, citándolos.
Eso es todo. La idea viene del paper de Lewis et al. (2020), y su elegancia es justamente esa: en vez de reentrenar un modelo con tus datos (caro y lento), le acercás el conocimiento en el momento de la pregunta.
Y hay un detalle económico escondido en ese diseño que casi nadie hace explícito: los LLMs cobran por cada token que LEEN, no solo por los que escriben. Ahora pensá qué separa “le mando los 3 fragmentos relevantes” de “le mando los documentos enteros”… multiplicado por cada pregunta, de cada usuario, todos los días. No te doy el número, hacé la cuenta con tu caso de uso y vas a entender por qué buscar() es la función que paga las otras dos.
¿Entonces los frameworks (LangChain, LlamaIndex) están mal? No. Están bien para orquestar. El problema es adoptarlos ANTES de entender las tres funciones. Porque cuando el sistema responde mal en producción -y va a responder mal- la pregunta que define todo es: ¿falló el retrieval (trajo documentos irrelevantes) o falló la generación (tenía los documentos correctos y respondió cualquier cosa)? Son dos problemas distintos, con dos arreglos distintos, y solo se pueden medir por separado si sabés dónde termina una función y empieza la otra. La abstracción que no entendés no te ahorra trabajo: te lo esconde hasta el peor momento.
Te comparto una pregunta que me queda picando:
- Los modelos nuevos aceptan contextos gigantes (¡millones de tokens!). ¿Eso mata al RAG… o lo vuelve más importante que nunca? Pista: la respuesta no es solo técnica.
más abajo, la notebook con el RAG completo en ~30 líneas, sin frameworks, para que veas las tres funciones desnudas antes de decidir qué herramienta las envuelve
Para reproducirlo
Notebook04_rag_minimo.ipynb Próximamente